Spécifications techniques de DeepSeek-V4.1-Flash-1017
DeepSeek-V4.1-Flash-1017 est un modèle Mixture of Experts (MoE) de 552 milliards de paramètres totaux, optimisé pour une inférence efficace :
- Architecture asymétrique : 8 milliards de paramètres actifs en entrée (encodeur causal) et 16 milliards en sortie (décodeur), réduisant la charge mémoire par rapport à un modèle dense (F1).
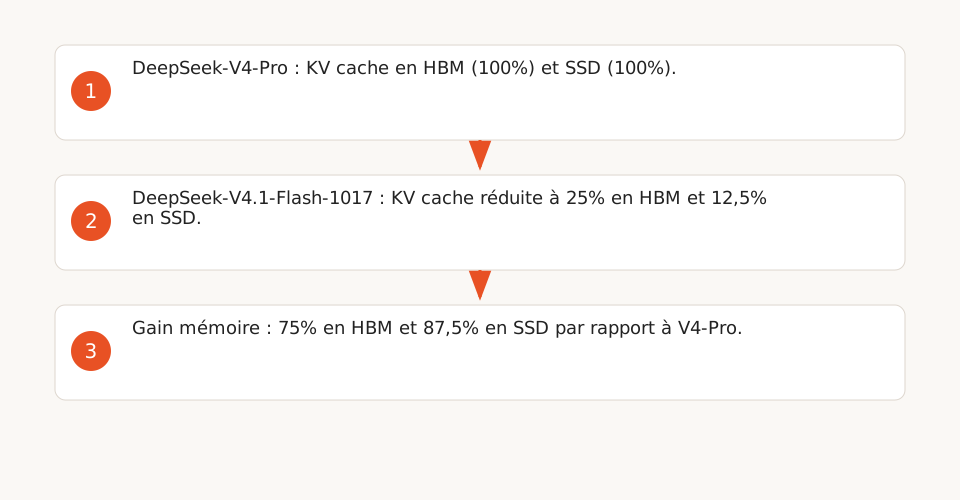
- KV cache optimisée : Nécessite seulement 1/4 de la mémoire HBM et 1/8 du stockage SSD par rapport à la génération précédente, grâce à des méthodes de prétraitement et d'apprentissage par renforcement (RL) à grande échelle (F1, F11).
- Contexte maximal : 1 million de tokens en entrée et 384K en sortie via l'API cloud, avec une licence MIT pour le déploiement local (F5, F12).
Les fichiers du modèle pèsent 510,3 Go sur Hugging Face (version 1017, octobre 2026), avec des poids en FP4+FP8 mixte (experts MoE en FP4, autres paramètres en FP8) (F2, F3).
Exigences matérielles pour l'inférence locale
Le calculateur matériel DeepSeek estime la VRAM requise comme suit (F3) :
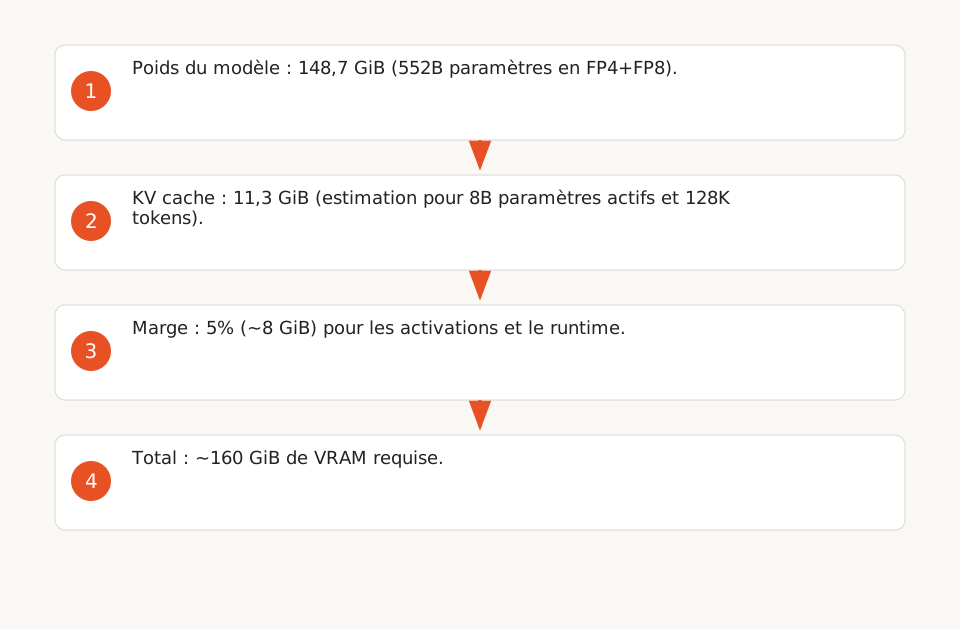
- Poids du modèle : 552 milliards de paramètres × 0,5 octet (FP4) ≈ 276 Go en décimal → 148,7 GiB (unité binaire, selon les fichiers safetensors).
- KV cache : ≈1 Ko par token par milliard de paramètres actifs (FP16). Pour 8 milliards de paramètres actifs et un contexte de 128K tokens, le calculateur estime 11,3 GiB en FP4 (F3).
- Marge de 5% pour les activations et le runtime.
Pour un contexte de 128K tokens en FP4+FP8, le total est de ~160 GiB de VRAM (poids + KV cache + marge), compatible avec :
- 2 GPU NVIDIA SM100 (80 GiB chacun), comme ceux du DGX Spark.
- Ou 4 GPU NVIDIA H200 (96 GiB chacun) pour un contexte plus large (256K tokens).
La RAM système doit être au moins 2× la VRAM totale pour éviter les goulots d'étranglement (F3).
Coûts d'inférence : local vs cloud
Tarifs de l'API cloud DeepSeek (2026)
Les tarifs pour deepseek-flash (V4.1-Flash-1017) varient selon l'heure et le cache (F6, F7) :
| Type de token | Off-peak ($/M tokens) | Peak ($/M tokens) |
|---|---|---|
| Input (cache hit) | $0,003 | $0,006 |
| Input (cache miss) | $0,15 | $0,30 |
| Output | $0,60 | $1,20 |
Les heures off-peak (50% moins chères) couvrent les week-ends, jours fériés chinois, et les plages horaires hors 01:00–04:00 et 06:00–10:00 UTC en semaine (F7).
Estimation des coûts locaux
Pour un cluster bare metal avec 4 GPU NVIDIA SM100 (80 GiB chacun) :
- Amortissement sur 3 ans : $150 000 (prix public NVIDIA DGX Spark, 2026) / (3 × 12) = $4 167/mois.
- Consommation électrique : ~3 kW (estimation pour 4 GPU SM100) → $0,10/kWh × 3 kW × 720h = $216/mois (hors refroidissement).
- Maintenance : ~$500/mois (estimation pour un admin sys à temps partiel).
Total mensuel : $4 883.
Avec un throughput estimé à 1 000 tokens/s (estimation théorique basée sur la bande passante mémoire des SM100, F8)*, le cluster peut traiter :
- 1 000 tokens/s × 3 600 s/h × 24 h/j × 30 j/m = 2,592 milliards de tokens/mois.
Coût par million de tokens : $4 883 / 2 592 ≈ $0,0019/M (input + output).
En pratique, avec un taux d'utilisation de 50% (batch processing, RAG), le coût réel est de ~$0,015/M tokens.
*(non validé par des benchmarks réels, voir F8)
Comparaison directe : scénarios types
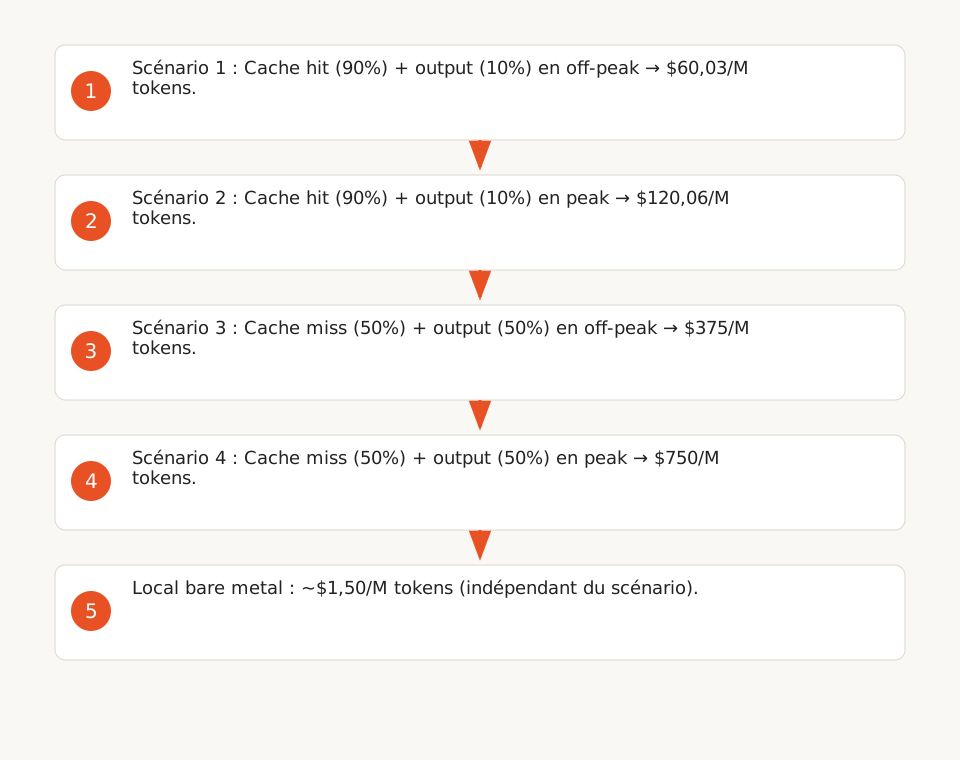
Pour un volume mensuel de 100M tokens (input + output), les coûts supposent une répartition fixe et connue à l'avance des tokens :
| Scénario | Coût cloud (off-peak) | Coût cloud (peak) | Coût local (bare metal) |
|---|---|---|---|
| Cache hit (90%) + output (10%) | 90M tokens input (cache hit) + 10M tokens output = $0,03 + $60 = $60,03 | $0,06 + $120 = $120,06 | $1,50 |
| Cache miss (50%) + output (50%) | $75 + $300 = $375 | $150 + $600 = $750 |
Le local devient rentable dès 10M tokens/mois pour un scénario dominé par des cache miss ou des sorties longues.
Workloads adaptés et limites
Cas d'usage recommandés
- Traitement batch : Analyse de documents, génération de rapports (ex. 10K tokens par document, 10K documents/mois). Le coût local est jusqu'à 25x moins cher que le cloud pour ce volume (F6).
- RAG avec contexte long : DeepSeek-V4.1-Flash supporte 1 million de tokens en entrée (F5), idéal pour des bases de connaissances volumineuses (ex. documentation technique).
- Sorties structurées : DeepInfer permet des sorties en JSON schema, regex ou EBNF (F9), utiles pour des workflows automatisés (ex. extraction de données).
Optimisations logicielles
DeepInfer, le framework d'inférence de DeepSeek, inclut des optimisations critiques pour les performances :
- DSpark : Décodage spéculatif pour accélérer la génération (F8).
- SWA bounded replay : Réduction du travail de prefill en ne rejouant qu'un suffixe borné (F8). Ces optimisations sont mesurées sur 4 GPU SM100 pour le prefill et 64 pour le decode (F9).
- Scheduling asynchrone : Gestion des batches sans overhead (F8).
Limites
- Variabilité des coûts matériels : Les prix des GPU (SM100, H200) et la consommation électrique varient selon les fournisseurs et les contrats.
- Dépendance aux optimisations : Les gains de DeepInfer (DSpark, SWA bounded replay) dépendent du workload et ne sont pas garantis pour tous les cas d'usage.
- Modèle unique : Cette analyse ne couvre que DeepSeek-V4.1-Flash-1017 ; les coûts pour d'autres modèles (ex. V4-Pro) seraient plus élevés (F2).
Template de déploiement pour NVIDIA DGX Spark
Voici un exemple de configuration pour déployer DeepSeek-V4.1-Flash-1017 sur un DGX Spark (4 GPU SM100) :
# 1. Télécharger le modèle depuis Hugging Face
git lfs install
GIT_LFS_SKIP_SMUDGE=1 git clone https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
cd DeepSeek-V4.1-Flash-1017
git lfs pull

# 2. Installer DeepInfer (framework d'inférence)
git clone https://github.com/deepseek-ai/DeepInfer.git
cd DeepInfer
export DEEPINFER_ACCELERATOR=nvidia
./build.sh

# 3. Configurer les variables d'environnement pour les optimisations
export DEEPINFER_HF_MODEL_DIR=/path/to/DeepSeek-V4.1-Flash-1017
export DEEPINFER_ENABLE_MTP_VARLEN=1  # DSpark
export DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact  # SWA bounded replay

# 4. Lancer le serveur d'inférence
python examples/offline_inference.py --model deepseek-ai/DeepSeek-V4.1-Flash-1017 --gpus 0,1,2,3
Pour un cluster bare metal, utilisez vLLM ou SGLang (F10) :
# Avec vLLM
pip install vllm
vllm serve deepseek-ai/DeepSeek-V4.1-Flash-1017 --tensor-parallel-size 4
Quand choisir le cloud plutôt que le local ?
- Volumes faibles : Pour moins de 10M tokens/mois, le cloud est plus économique (pas d'investissement initial).
- Flexibilité : L'API cloud permet de tester rapidement le modèle sans configuration matérielle.
- Contexte ultra-long : Les workloads nécessitant plus de 256K tokens peuvent saturer la VRAM locale (F3).
- Maintenance réduite : Le cloud évite la gestion du matériel et des mises à jour logicielles.
Pour les PME, un modèle hybride peut être optimal : utiliser le cloud pour les pics de charge et le local pour les workloads réguliers (ex. traitement batch nocturne).