DGX Spark : matériel local optimisé pour l’IA
Le NVIDIA DGX Spark (F1-F5) est une plateforme conçue pour exécuter des modèles d’IA en local, sans dépendre du cloud. Voici ses capacités, **telles que documentées par NVIDIA** :
Spécifications techniques
| Composant | Détails |
|---|---|
| Processeur | NVIDIA Grace Blackwell Superchip (architecture Blackwell optimisée pour l’IA, F1). |
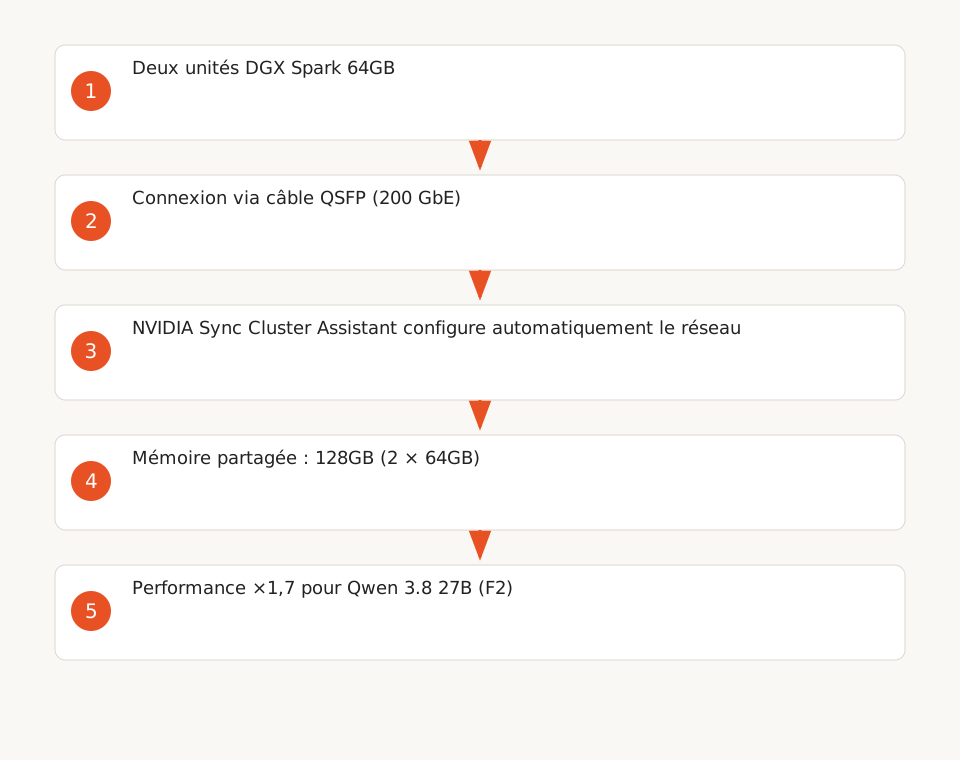
| Mémoire | 64GB de mémoire unifiée (extensible à 128GB en clusterant 2 unités via NVIDIA Sync Cluster Assistant, F2). |
| Stockage | 1TB-4TB NVMe avec chiffrement matériel SED (Self-Encrypting Drive, F6). |
| Réseau | NIC NVIDIA ConnectX-7 (200 GbE) pour le clustering direct via câble QSFP (F3). |
| OS | Ubuntu 24.04 avec noyau Linux v6.11 (F7). |
| Pile logicielle | CUDA, cuDNN, TensorRT, NCCL, PyTorch avec CUDA, TensorRT-LLM (optimisé pour Blackwell, F5). |
| Outils IA | NVIDIA Agent Toolkit, Nemotron (modèles ouverts), Ollama (préinstallé par défaut sur DGX Spark, F5), vLLM, llama.cpp. |
| Prix | À partir de 4 999 $ (64GB, disponible chez Acer, ASUS, Dell, etc., F4). |
Performances et limites
- Modèles supportés : Jusqu’à 100 milliards de paramètres sur un seul nœud (64GB), jusqu’à 200 milliards de paramètres (en clusterant deux unités, F2).
- Benchmark NVIDIA : Performance ×1,7 pour le modèle Qwen 3.8 27B en cluster (F2). Ce résultat est spécifique à ce modèle et à cette configuration (benchmark interne NVIDIA). Les performances varient selon la taille du contexte et le type de tâche.
- Clustering : Deux unités DGX Spark peuvent être connectées via un câble QSFP, avec configuration automatique du réseau via NVIDIA Sync Cluster Assistant (F3).
- Sécurité : Chiffrement matériel du stockage (SED, F6), mais le chiffrement des données en transit (ex. : entre n8n et le DGX Spark) doit être configuré manuellement via TLS (non inclus dans le matériel). Le dTPM est désactivé par défaut (F6).
Exemple : Déployer un modèle local avec Ollama
Le DGX Spark supporte des frameworks comme Ollama (**préinstallé par défaut sur DGX Spark**, F5), qui simplifie le déploiement de modèles locaux. Voici les étapes pour exécuter Qwen 3.8 27B (exemple basé sur le modèle testé par NVIDIA en F2) :
# Lancer le modèle Qwen 3.8 27B (Ollama est préinstallé)
ollama pull qwen:27b
ollama run qwen:27b
Une fois le modèle déployé, il est accessible via une API locale (ex. : http://localhost:11434/api/generate).
n8n : orchestrer vos workflows IA en local
n8n (F9-F12) est un outil d’automatisation open-source qui peut être auto-hébergé pour orchestrer des workflows IA sans dépendre du cloud. Voici comment le configurer :
Installation et configuration
n8n s’installe en une ligne via Docker (F12) :
curl -fsSL https://get.n8n.io | shPour une configuration plus robuste (persistance, sécurité), utilisez Docker Compose avec PostgreSQL (F12) :
version: '3'
services:
  n8n:
    image: n8nio/n8n
    restart: always
    ports:
      - "5678:5678"
    environment:
      - N8N_BASIC_AUTH_ACTIVE=true
      - N8N_BASIC_AUTH_USER=<votre_utilisateur>
      - N8N_BASIC_AUTH_PASSWORD=<votre_mot_de_passe>
      - DB_TYPE=postgresdb
      - DB_POSTGRESDB_DATABASE=n8n
      - DB_POSTGRESDB_HOST=postgres
      - DB_POSTGRESDB_PORT=5432
      - DB_POSTGRESDB_USER=n8n
      - DB_POSTGRESDB_PASSWORD=<votre_mot_de_passe>
    volumes:
      - n8n_data:/home/node/.n8n
  postgres:
    image: postgres:13
    restart: always
    environment:
      - POSTGRES_USER=n8n
      - POSTGRES_PASSWORD=<votre_mot_de_passe>
      - POSTGRES_DB=n8n
    volumes:
      - postgres_data:/var/lib/postgresql/data
volumes:
  n8n_data:
  postgres_data:
Fonctionnalités clés pour les workflows IA
- Appels API : n8n permet d’intégrer des appels à des modèles locaux déployés sur le DGX Spark (F11).
- Déclencheurs : Déclencher des workflows via des événements (ex. : réception d’un email, upload d’un fichier).
- Outils personnalisés : Utiliser des outils comme
Call n8n Workflow Toolpour appeler d’autres workflows (F11). - Persistance : Stocker les données dans PostgreSQL pour éviter les pertes (F12).
- Sécurité : Configurer l’authentification basique et le chiffrement des volumes (F12).
Intégration DGX Spark + n8n : workflow concret
Aucune intégration native n’existe entre DGX Spark et n8n (limitation documentée). Voici comment les connecter manuellement pour un workflow de traitement de documents :
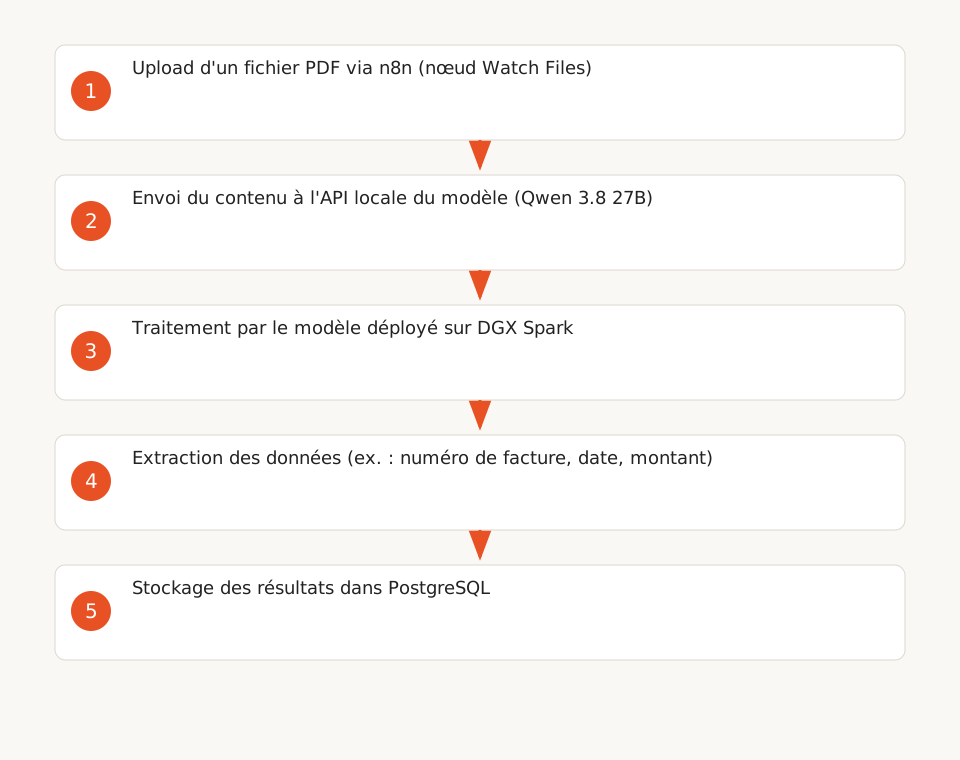
Scénario : Extraction de données depuis des factures PDF
- Déployer un modèle local sur DGX Spark : Utilisez Ollama pour exécuter un modèle comme Qwen 3.8 27B (voir exemple ci-dessus).
- Configurer n8n pour appeler le modèle : Utilisez le nœud
HTTP Requestpour envoyer des requêtes à l’API locale du modèle. - Automatiser le workflow : Déclenchez le workflow via un upload de fichier (ex. : nœud
Watch Files), puis envoyez le contenu du PDF au modèle pour extraction. - Stocker les résultats : Utilisez un nœud
PostgreSQLpour sauvegarder les données extraites.
Template n8n prêt à l’emploi
Voici un template JSON pour un workflow n8n qui traite des documents locaux avec un modèle déployé sur DGX Spark. Importez-le dans votre instance n8n via Workflow menu > Import from file :
{
  "nodes": [
    {
      "parameters": {
        "path": "/data/uploads",
        "options": {}
      },
      "name": "Watch Files",
      "type": "n8n-nodes-base.watchFiles",
      "typeVersion": 1,
      "position": [250, 300]
    },
    {
      "parameters": {
        "authentication": "none",
        "requestMethod": "POST",
        "url": "http://localhost:11434/api/generate",
        "options": {
          "bodyContentType": "json"
        },
        "bodyParametersJson": "={\n  \"model\": \"qwen:27b\",\n  \"prompt\": \"Extract the invoice number, date, and total amount from this text: {{ $json[\"fileContent\"] }}\",\n  \"stream\": false\n}"
      },
      "name": "HTTP Request to Local Model",
      "type": "n8n-nodes-base.httpRequest",
      "typeVersion": 4,
      "position": [500, 300]
    },
    {
      "parameters": {
        "operation": "executeQuery",
        "query": "INSERT INTO extracted_data (invoice_number, date, total_amount) VALUES ('{{ $json[\"response\"][\"invoice_number\"] }}', '{{ $json[\"response\"][\"date\"] }}', '{{ $json[\"response\"][\"total_amount\"] }}');"
      },
      "name": "PostgreSQL",
      "type": "n8n-nodes-base.postgres",
      "typeVersion": 1,
      "position": [750, 300]
    }
  ],
  "connections": {
    "Watch Files": {
      "main": [[{
        "node": "HTTP Request to Local Model",
        "type": "main",
        "index": 0
      }]]
    },
    "HTTP Request to Local Model": {
      "main": [[{
        "node": "PostgreSQL",
        "type": "main",
        "index": 0
      }]]
    }
  }
}
Limites et prérequis techniques
- Pas d’intégration native : Vous devez configurer manuellement les appels API entre n8n et le DGX Spark (F11).
- Chiffrement des données : Le stockage DGX Spark est chiffré par défaut (SED, F6), mais le chiffrement des données en transit (ex. : entre n8n et le DGX Spark) doit être configuré manuellement via TLS.
- Performances : Les benchmarks NVIDIA (×1,7 en cluster) sont spécifiques au modèle Qwen 3.8 27B (F2). Testez vos modèles avant de scaler.
- Configuration manuelle : n8n en self-hosting nécessite une configuration pour la persistance (PostgreSQL), la sécurité (authentification, volumes chiffrés) et le monitoring (F12).
- Coûts opérationnels : Le prix du DGX Spark (4 999 $, F4) ne couvre pas les coûts de maintenance, d’électricité ou de refroidissement.
Comparaison : local vs cloud
Voici une comparaison des coûts et des performances pour un workflow de traitement de documents, basée sur les sources (F2, F4, F6) :
| Critère | Local (DGX Spark + n8n) | Cloud (API + outil d’automatisation) |
|---|---|---|
| Coût initial | 4 999 $ (DGX Spark 64GB) + coût matériel n8n (ex. : serveur dédié). | Aucun coût initial, mais frais récurrents variables selon les fournisseurs. |
| Coût mensuel | Électricité (~50-100 $/mois) + maintenance. | Frais récurrents variables (ex. : coûts par requête selon les fournisseurs). |
| Confidentialité | Données 100 % locales (pas de transfert vers des tiers, F6). | Données envoyées vers des APIs cloud (risque de fuite). |
| Latence | Faible (traitement local, F2). | Variable (dépend de la connexion internet). |
| Scalabilité | Scalable via clustering (jusqu’à 200 milliards de paramètres, F2). | Illimitée (mais coûteuse). |
| Maintenance | Requise (mises à jour, monitoring via nvidia-smi, F8). |
Aucune (gérée par le fournisseur cloud). |
Recommandations pour les ops
- Commencez par un déploiement minimal : Déployez un seul nœud DGX Spark (64GB) et testez vos workflows avant de scaler (F2).
- Sécurisez les données : Activez le chiffrement des volumes (SED, F6) et configurez TLS pour les communications entre n8n et le DGX Spark.
- Monitoring : Utilisez
nvidia-smiet les outils de télémétrie du DGX Spark pour surveiller les performances (F8). - Persistance : Configurez PostgreSQL pour n8n afin d’éviter les pertes de données (F12).
- Documentation : Documentez vos workflows et vos configurations pour faciliter la maintenance.
Ressources utiles
- Expertise Keerok : Automatisation no-code avec Make et Zapier (pour comparer avec d’autres outils).
- Guide : Implémenter l’IA en entreprise sans cloud (bonnes pratiques pour les ops).
- Hub : Automatisation no-code (Make, Zapier, n8n) (ressources complémentaires).
- Documentation n8n (pour configurer votre instance).
- Blog NVIDIA : DGX Spark (spécifications techniques, F1-F5).