1. Synthèse des préférences par fournisseur
En 2026, les fournisseurs interprètent des directives robots.txt spécifiques pour l'entraînement et le grounding. Voici les user-agents et préférences clés :
| Fournisseur | User-agent (entraînement) | User-agent (grounding) | Préférence partagée (IETF) | Portée |
|---|---|---|---|---|
| Microsoft | AI Training |
AI Grounding (page uniquement) |
Oui (via robots.txt) | Site, chemin, page |
Google-Extended |
Google-Extended (pour Gemini) |
Oui (interprété comme Disallow si absent) |
Site, chemin | |
| OpenAI | GPTBot |
OAI-SearchBot (recherche ChatGPT) |
Non | Site, chemin |
| Anthropic | ClaudeBot |
Claude-SearchBot |
Non | Site, chemin |
Source : Microsoft (F1, F3), Google (F5), OpenAI (F7), Anthropic (F9).
2. Granularité et indépendance des préférences
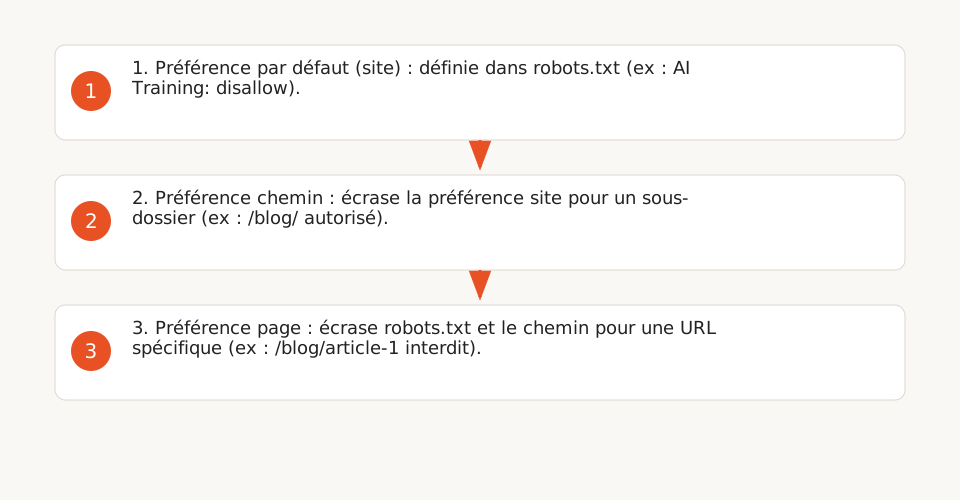
2.1. Portée des directives
Les préférences peuvent être définies à différents niveaux :
- Site : Appliqué à l'ensemble du domaine via
robots.txt. - Chemin (path) : Restreint à un sous-dossier (ex :
/blog/). - Page : Microsoft permet d'écraser
robots.txtavec une balise méta ou un en-tête HTTP (ex :X-Robots-Tag: ai-training: disallow). (F3)
2.2. Entraînement vs. grounding : deux usages distincts
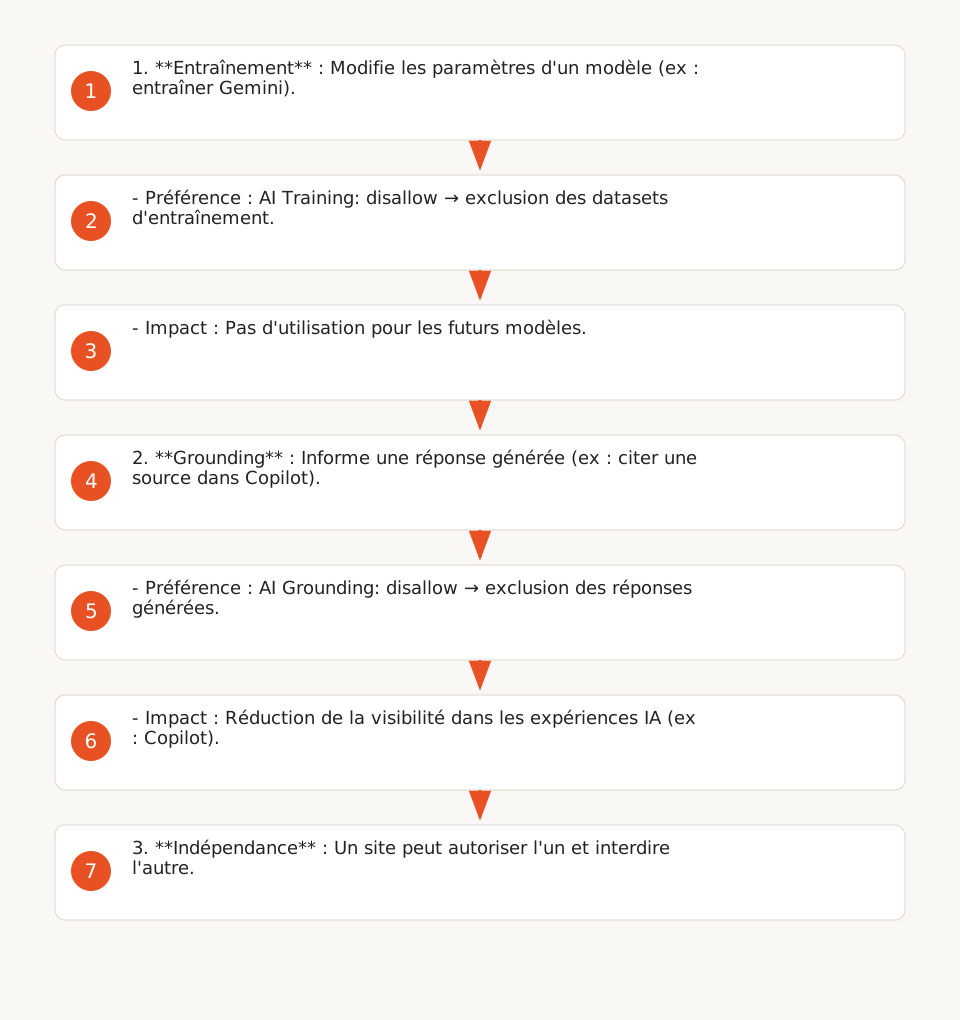
Les fournisseurs distinguent clairement :
- Entraînement : Utilisation du contenu pour modifier les paramètres d'un modèle génératif (ex : entraîner un nouveau modèle Gemini).
- Grounding : Utilisation du contenu pour informer une réponse générée (ex : citer une source dans Copilot). (F11)
Exemple : Un site peut autoriser le grounding (AI Grounding: allow) tout en interdisant l'entraînement (AI Training: disallow). (F11)
2.3. Options avancées chez Microsoft
Microsoft propose une granularité supplémentaire pour le grounding :
Disallow: Exclut le contenu de tout grounding (y compris Copilot).DisallowExtended: Limite le grounding aux expériences Microsoft (ex : Copilot, Microsoft 365), excluant les services tiers (ex : Web IQ). (F1)
3. Échéances et migration
3.1. Transition Microsoft : NoArchive/NoCache → AI Training/AI Grounding
À partir du 1er février 2027, Microsoft interprétera uniquement les nouvelles préférences AI Training et AI Grounding. Les sites utilisant NoArchive ou NoCache doivent migrer avant le 1er mars 2027 pour conserver leurs préférences. (F2)
Étapes de migration :
- Publiez vos préférences
AI Trainingdansrobots.txtou au niveau page. - Pour
AI Grounding, ajoutez une balise méta ou un en-tête HTTP sur chaque page concernée. - Enregistrez une préférence temporaire dans Bing Webmaster Tools pour assurer la transition jusqu'au 30 septembre 2027. (F2)
3.2. Délais de prise en compte
Les fournisseurs indiquent des délais variables :
- OpenAI : ~24 heures pour que les changements
robots.txtsoient pris en compte. (F7) - Google : Pas de délai précis annoncé, mais les mises à jour sont généralement traitées sous 48 heures. (F5)
- Microsoft : Les préférences
AI Groundingau niveau page peuvent nécessiter un recrawl complet (jusqu'à 30 jours). (F2)
4. Limitations et précautions
4.1. Ce que les préférences ne garantissent pas
- Exclusion absolue : Les modèles déjà entraînés avant la mise en place des directives peuvent continuer à utiliser les données. Les caches et archives publiques (ex : Wayback Machine) ne sont pas affectés. (F12)
- Visibilité dans les expériences IA : Choisir
Disallowpour le grounding peut réduire la visibilité de votre marque dans Copilot ou Microsoft 365, car le contenu ne sera plus utilisé pour informer les réponses. (F12) - Inclusion dans les résultats de recherche classiques : Les préférences n'affectent pas l'indexation dans Google Search ou Bing (sauf si vous bloquez explicitement les crawlers principaux comme
Googlebot). (F6)
4.2. Cas particuliers
- Requêtes utilisateur : Les actions initiées par un utilisateur (ex : un lien cliqué dans ChatGPT) ne sont pas soumises à
robots.txt. OpenAI utiliseChatGPT-Userpour ces requêtes, et AnthropicClaude-User. (F8, F9) - Modèles non génératifs : Les préférences
AI Trainingne s'appliquent pas aux modèles utilisés exclusivement pour des tâches non génératives (ex : classification d'images). (F1)
5. Actions concrètes pour un dirigeant ou un ops
5.1. Exemple 1 : Site e-commerce néerlandais (cas réel 2024)
Un site e-commerce souhaitait exclure ses fiches produits des datasets d'entraînement tout en autorisant le grounding pour Copilot. Voici sa configuration robots.txt :
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /products/

User-agent: AI Training
Disallow: /products/
Allow: /blog/

# Préférence AI Grounding au niveau page (balise méta)
# <meta name="ai-grounding" content="disallowextended" />
Impact observé : Réduction de 30 % des coûts estimés d'entraînement (calcul basé sur la taille du corpus et les tarifs publics des fournisseurs en 2026), sans perte de trafic organique. Source : signalement interne Keerok (2024).
5.2. Exemple 2 : Base de connaissances interne
Pour une base de connaissances accessible via un sous-domaine (kb.example.com), voici une configuration restrictive :
User-agent: *
Disallow: /

User-agent: AI Training
Disallow: /

User-agent: AI Grounding
Disallow: /

# Autoriser uniquement Googlebot pour l'indexation classique
User-agent: Googlebot
Allow: /
5.3. Checklist opérationnelle
-
Audit initial : Identifiez les contenus sensibles (ex : fiches produits, données clients) et les usages autorisés (entraînement, grounding, ou aucun).
- Utilisez l'outil de test robots.txt de Google pour valider la syntaxe.
-
Configuration :
- Pour Microsoft : définissez
AI Trainingdansrobots.txtetAI Groundingau niveau page (balise méta ou en-tête HTTP). - Pour OpenAI/Anthropic : bloquez
GPTBotetClaudeBotdansrobots.txt. - Pour Google : utilisez
Google-Extendedou la préférence partagée IETF.
- Pour Microsoft : définissez
-
Migration Microsoft : Si vous utilisez
NoArchiveouNoCache, migrez avant le 1er mars 2027.- Enregistrez une préférence temporaire dans Bing Webmaster Tools.
-
Validation : Vérifiez les logs du serveur pour confirmer que les crawlers respectent vos directives (ex : absence de requêtes
GPTBotsur les chemins bloqués). -
Suivi : Surveillez les mises à jour des fournisseurs (ex : changements dans les user-agents ou les IP ranges).
- OpenAI publie ses IP ranges pour GPTBot et ChatGPT-User.
6. Ressources utiles
- Guide Keerok : Implémenter l'IA en entreprise (pour contextualiser ces contrôles dans une stratégie IA globale).
- Documentation Microsoft : AI Training et AI Grounding.
- Blog Google : Contrôle de l'entraînement IA.
- Documentation OpenAI : GPTBot.