1. Rate Limiting : règles concrètes pour protéger vos APIs et workflows
Le *rate limiting* permet de contrôler l’accès à une ressource en limitant le nombre de requêtes autorisées sur une période donnée, avec des critères précis par client, endpoint ou ressource. Contrairement au *throttling* (limites globales), il offre un contrôle granulaire pour éviter les blocages tout en respectant les quotas des APIs tierces.
1.1 Critères de comptage et exemples (Cloudflare)
Cloudflare propose des règles de *rate limiting* avec des critères variés, disponibles selon les plans *Business* ou *Advanced Rate Limiting* [F1][F3] :
- User Agent : Limiter les requêtes d’une app mobile à 100 requêtes/10 min (comptage par IP). [F1]
- IP : Bloquer les requêtes excessives vers un endpoint sensible (ex: /login).
- Clearance UUID : Limiter les requêtes vers /checkout à 100 requêtes/10 min (action *Block*), en excluant les requêtes sans cookie de clearance. [F2]
- Host : Pour les SaaS avec plusieurs hôtes sous une même zone, utiliser le *Host* comme critère de comptage. [F4]
- ASN ou liste d’IPs : Exclure des IPs partenaires (ex: liste *partner_ips*) des limites. [F4]
1.2 Exemple : protection d’un endpoint /login (Cloudflare)
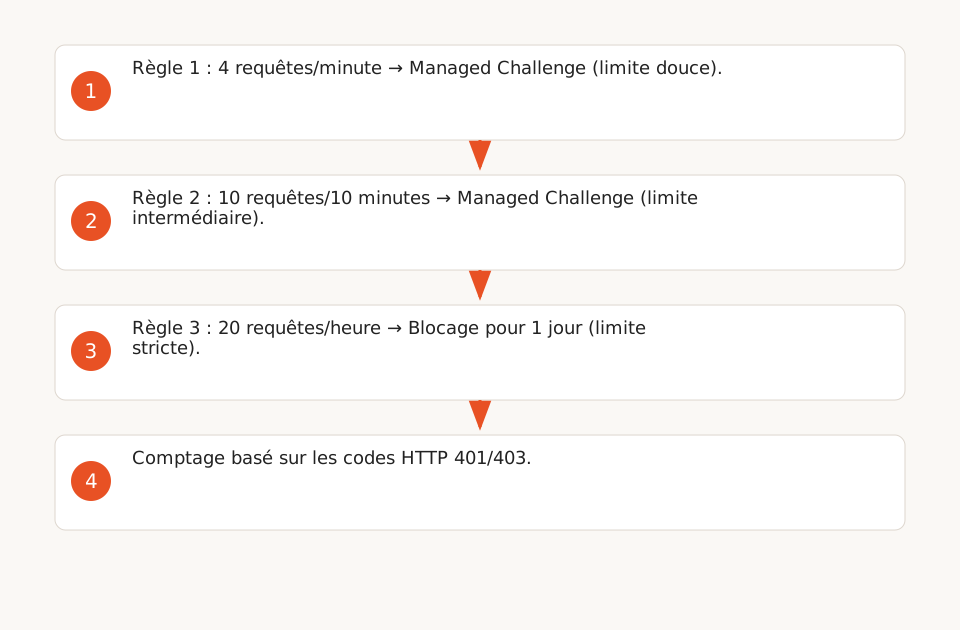
Cloudflare montre un exemple de *rate limiting* multi-niveaux pour un endpoint /login (méthode POST), avec des actions progressives :
- Règle 1 : 4 requêtes/minute → *Managed Challenge* (limite douce).
- Règle 2 : 10 requêtes/10 minutes → *Managed Challenge* (limite intermédiaire).
- Règle 3 : 20 requêtes/heure → Blocage pour 1 jour (limite stricte). [F3]
Le comptage est basé sur les codes HTTP 401/403, ciblant spécifiquement les tentatives d’authentification échouées.
1.3 Actions disponibles
Cloudflare propose plusieurs actions pour gérer les dépassements :
- Block : Bloquer la requête et retourner une erreur 429.
- Managed Challenge : Afficher un CAPTCHA ou un défi JavaScript pour vérifier que le client est un humain.
- JS Challenge : Exécuter un script JavaScript pour valider le client.
- Log : Enregistrer la requête sans la bloquer (utile pour le débogage).
1.4 Limites et précautions
- Les règles avancées (ex: multi-niveaux ou critères comme *Clearance UUID* et *ASN*) nécessitent un plan *Business* ou *Advanced Rate Limiting* chez Cloudflare. [F3]
- Testez les règles en environnement de staging pour éviter de bloquer des clients légitimes.
2. Retry : backoff exponentiel + jitter pour éviter les surcharges
Quand une API retourne une erreur 429 ou 5xx, un *retry* mal configuré peut aggraver la situation en surchargeant le serveur. Les bonnes pratiques consistent à utiliser un backoff exponentiel (délais croissants entre les tentatives) et du jitter (délai aléatoire ajouté pour étaler les requêtes).
2.1 Paramètres clés (Google Cloud Client Libraries)
Google Cloud Client Libraries (Java) implémente des retries avec les paramètres suivants :
- InitialRetryDelayDuration : Délai initial avant le premier retry (ex: 100 ms). [F5]
- RetryDelayMultiplier : Multiplicateur pour le délai entre chaque retry (ex: 1.3 ou 2.0).
- MaxRetryDelayDuration : Délai maximum entre deux retries (ex: 60 s).
- TotalTimeoutDuration : Temps total alloué pour les retries (ex: 60 s).
2.2 Exemple de backoff exponentiel + jitter
Voici comment fonctionne un backoff exponentiel avec jitter :
- Délai initial : 100 ms.
- Multiplicateur : 2.0.
- Délai maximum : 500 ms.
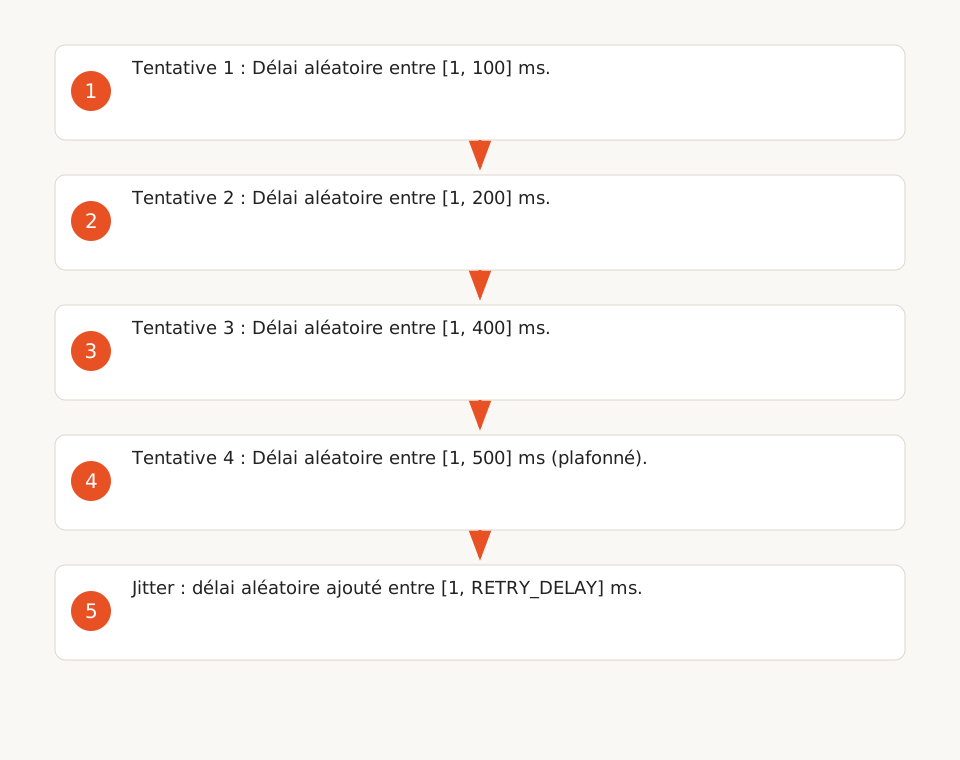
- Jitter : Délai aléatoire ajouté entre [1, RETRY_DELAY] ms. [F6]
Résultat :
- Tentative 1 : Délai aléatoire entre [1, 100] ms.
- Tentative 2 : Délai aléatoire entre [1, 200] ms.
- Tentative 3 : Délai aléatoire entre [1, 400] ms.
- Tentative 4 : Délai aléatoire entre [1, 500] ms (plafonné).
2.3 Algorithme recommandé (Google Cloud IAM)
Google Cloud IAM recommande un *truncated exponential backoff with jitter* pour les erreurs 500, 502, 503, 504 (et optionnellement 404). L’algorithme est le suivant :
- Délai = min(2n + random-fraction, max-backoff), où n est incrémenté à chaque retry.
- Exemple :
- Tentative 1 : 1 + random-fraction secondes.
- Tentative 2 : 2 + random-fraction secondes.
- Tentative 3 : 4 + random-fraction secondes.
- ...
- Délai maximum : 60 secondes.
- Deadline : 300 secondes (arrêt des retries). [F7]
2.4 Template prêt à l’emploi (Python)
Voici un exemple de code Python pour implémenter un retry avec backoff exponentiel + jitter :
import time
import random
import requests

def retry_with_backoff(
    func,
    initial_delay=0.1,
    max_delay=60,
    multiplier=2.0,
    deadline=300,
    retryable_codes=(408, 429, 500, 502, 503, 504),
):
    start_time = time.time()
    attempt = 0
    while True:
        try:
            response = func()
            if response.status_code not in retryable_codes:
                return response
        except requests.exceptions.RequestException as e:
            if not is_retryable_exception(e):
                raise

        elapsed = time.time() - start_time
        if elapsed >= deadline:
            raise Exception("Retry deadline exceeded")

        delay = min(initial_delay * (multiplier ** attempt), max_delay)
        jitter = random.uniform(0, delay)
        time.sleep(jitter)
        attempt += 1

def is_retryable_exception(e):
    # Vérifier si l'exception est retryable (ex: timeout, disconnect)
    return isinstance(e, (requests.exceptions.Timeout, requests.exceptions.ConnectionError))

# Exemple d'utilisation
response = retry_with_backoff(
    lambda: requests.get("https://api.example.com/data"),
    initial_delay=0.1,
    max_delay=60,
    multiplier=2.0,
    deadline=300,
)
2.5 Vécu Keerok : corriger un workflow n8n saturé
Sur une mission de migration, un workflow n8n relisait jusqu’à 20 000 produits par minute, combiné à trois autres workflows filtrant sur un champ global. Résultat : saturation de l’API avec des erreurs 429 en cascade. La correction a consisté à :
- Limiter le lookback à 5 minutes.
- Sauvegarder le lastRun en début d’exécution.
- Activer les retries sur les erreurs 429 avec un backoff exponentiel.
- Restreindre les formules aux champs pertinents. [E2]
Résultat : plus aucune erreur après 15 heures de test.
3. Throttling et quotas : limites globales et par client (AWS API Gateway)
Le *throttling* applique des limites globales pour protéger une infrastructure, contrairement au *rate limiting* (qui cible des clients ou endpoints spécifiques). AWS API Gateway utilise un algorithme de *token bucket* pour gérer ces limites.
3.1 Limites par défaut (AWS API Gateway)
- 10 000 requêtes par seconde (RPS) par compte et par région, burst inclusivement. [F10]
- Les clients reçoivent une erreur 429 au-delà de cette limite.
- Ces limites sont appliquées en *best-effort* : les clients peuvent les dépasser ponctuellement. [F12]
3.2 Usage Plans : limiter par client (API keys)
AWS API Gateway permet de configurer des *usage plans* pour limiter le débit par client (via des API keys) ou par méthode/endpoint :
- Exemple : limiter un client à 100 RPS pour une méthode spécifique. [F11]
- Les limites sont appliquées en *best-effort* et ne garantissent pas un blocage strict.
3.3 Recommandations AWS
- Utilisez AWS WAF pour un contrôle strict des limites (au lieu de se fier uniquement aux *usage plans*).
- Surveillez les coûts avec AWS Budgets, car les *usage plans* ne bloquent pas les dépassements. [F12]
4. Idempotence et codes HTTP retryables (Google Cloud Storage)
Tous les codes HTTP ne sont pas retryables, et toutes les opérations ne sont pas idempotentes. Voici comment déterminer si un retry est sûr.
4.1 Codes HTTP retryables
Google Cloud Storage définit les codes suivants comme retryables :
- 408 (Request Timeout), 429 (Too Many Requests), 5xx (Server Errors).
- Erreurs socket : timeouts, disconnects. [F8]
4.2 Idempotence des opérations
L’idempotence détermine si une opération peut être répétée sans changer l’état final de la ressource :
- Idempotent : Une opération *list* (ex: lister des fichiers) est toujours idempotente, car elle ne modifie pas la ressource.
- Non idempotent : Une opération *create* (ex: créer une notification Pub/Sub) ne l’est jamais pour les notifications Pub/Sub, car elle génère un nouvel ID à chaque exécution. Pour d’autres contextes, elle peut l’être sous conditions (ex: préconditions). [F8]
4.3 Configuration des retries (Google Cloud Storage Go)
Par défaut, Google Cloud Storage (Go) active les retries uniquement pour les opérations idempotentes :
- Délai initial : 1 seconde.
- Multiplicateur : 2.0.
- Délai maximum : 30 secondes. [F9]
5. Limites et bonnes pratiques
5.1 Ce que les sources ne couvrent pas
- Aucune source ne détaille le *throttling* côté client (ex: algorithmes de token bucket locaux).
- Les coûts ne sont pas directement adressés : les sources se concentrent sur la stabilité et la conformité aux quotas.
- Les seuils AWS (10k RPS) sont des cibles *best-effort*, pas des garanties strictes. [F12]
5.2 Bonnes pratiques pour vos workflows
- Testez en staging : Validez les règles de *rate limiting* pour éviter de bloquer des clients légitimes.
- Surveillez les logs : Utilisez des outils comme CloudWatch (AWS) ou Stackdriver (Google Cloud) pour détecter les erreurs 429 ou 5xx.
- Documentez les quotas : Notez les limites des APIs tierces (ex: Slack, Google Drive) et configurez vos workflows en conséquence.
- Utilisez des retries intelligents : Activez le backoff exponentiel + jitter pour éviter les surcharges.
- Limitez les opérations non idempotentes : Évitez les retries sur des opérations comme *create* ou *update* sans mécanisme d’idempotence. Voir notre guide sur l’idempotence (lien interne).