1. Choisir une architecture OpenAI pour votre agent vocal
OpenAI propose trois architectures pour les agents vocaux, chacune adaptée à des besoins spécifiques de contrôle et de complexité (F1) :
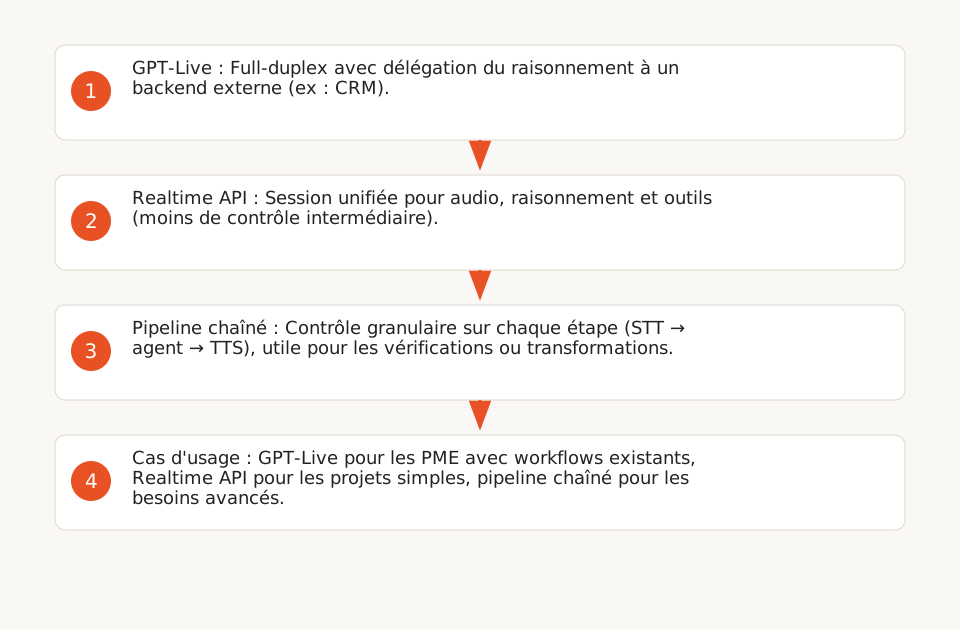
- GPT-Live : Full-duplex (écoute et parole simultanées) avec délégation du raisonnement à un backend externe. Idéal pour conserver un workflow texte existant (ex, CRM, base de connaissances) tout en ajoutant une interface vocale. Le backend gère les permissions et les règles métier, tandis que GPT-Live se concentre sur le comportement conversationnel (F2). Recommandé pour les PME : cette architecture permet de réutiliser des systèmes existants (ex : vérification de solde dans un CRM) sans tout reconstruire.
- Realtime API : Session unifiée pour l’audio, le raisonnement et les outils. Simplifie le développement en centralisant la logique dans un seul modèle, mais offre moins de contrôle sur les étapes intermédiaires.
- Pipeline chaîné : Contrôle granulaire sur chaque étape (STT → agent → TTS). Permet d’inspecter ou transformer le texte entre les étapes, utile pour ajouter des vérifications (ex : politiques de conformité) ou des appels à des systèmes internes avant la réponse (F3). Exemple de code :
@function_tool
def get_weather(city: str) -> str:
    """Récupère la météo pour une ville donnée."""
    return f"Météo à {city} : ensoleillé."

agent = Agent(
    name="Assistant",
    instructions="Vous êtes un assistant vocal utile.",
    model="",
    tools=[get_weather],
)
Note : Utilisez le modèle Realtime API le plus récent d'OpenAI (voir documentation officielle).
Lien utile : Notre expertise sur les agents IA pour choisir entre ces architectures.
2. Déléguer le backend : où placer la logique métier ?
Avec GPT-Live, la délégation du backend est un choix clé (F2) :
- Client delegation : Votre application exécute le travail backend (ex : requêtes API vers un CRM) et retourne les résultats à GPT-Live. Permet un contrôle total sur les permissions et les données.
- Responses delegation : Utilise un modèle OpenAI-hosted pour le raisonnement, mais votre application conserve le contrôle des fonctions personnalisées (ex : paiements, réservations).
Dans les deux cas, OpenAI recommande de séparer les règles métier (backend) des instructions vocales (prompt GPT-Live). Exemple :
- Prompt backend : « Vérifie que le client a un abonnement actif avant de proposer un rendez-vous. »
- Prompt GPT-Live : « Utilise un ton professionnel et confirme les actions à l’oral. »
Cette séparation permet de mettre à jour les règles sans modifier l’interface vocale, et vice versa.
3. Optimiser la synthèse vocale avec ElevenLabs
ElevenLabs propose une API TTS avec des paramètres pour équilibrer latence et qualité (F6) :
- Latence : Niveaux 0 (défaut) à 4 (max, avec normalisation désactivée). Le niveau 3 réduit la latence jusqu’à ~75 % de l’amélioration maximale possible (par rapport au niveau 0), mais peut affecter la prononciation des nombres et dates (F8).
- Continuité audio : Utilisez
previous_request_idsetnext_request_ids(max 3 par requête) pour lier plusieurs segments TTS et éviter les coupures (F7). Exemple d’usage : générer un flux audio long pour une annonce ou un message d’attente. - Formats audio : MP3 (tous tiers), WAV/PCM (Pro+), μ-law (compatible Twilio). Le format μ-law (8 kHz) est recommandé pour les appels téléphoniques (F6). Note : Les formats MP3 standard (ex : 32 kbps) sont disponibles sur tous les tiers. Le format MP3 192 kbps nécessite un abonnement au tier Creator (voir documentation ElevenLabs).
- Normalisation : ElevenLabs propose une normalisation du texte (nombres, dates) pour toutes les langues (modes
auto,on,off), et une normalisation linguistique spécifique (ex : japonais) qui peut augmenter la latence (F8).
4. Intégrer la téléphonie avec Twilio
Twilio Programmable Voice permet de gérer les appels via REST API ou TwiML (F9) :
- Appels sortants/entrants : Utilisez l’API pour déclencher des appels (ex : relances de paiement) ou router les appels entrants vers votre agent vocal.
- TwiML : Langage XML pour contrôler les appels. Exemple pour lire un texte et mettre en file d’attente :
<Response>
  <Say voice="woman">Bonjour, votre rendez-vous est confirmé pour demain à 14h.</Say>
  <Enqueue>files_d_attente</Enqueue>
</Response>- Fonctionnalités avancées : Files d’attente (
<Enqueue>), conférences, et enregistrements (paramètreRecord=true) (F11).
Pour connecter Twilio à votre agent OpenAI/ElevenLabs :
- Configurez un webhook Twilio pour recevoir les appels entrants.
- Transmettez l’audio à OpenAI (STT) ou ElevenLabs (TTS) via leurs APIs respectives.
- Retournez la réponse vocale à Twilio pour lecture à l’appelant.
Lien utile : Automatisation no-code avec Make/Zapier pour des intégrations simplifiées (sans développement backend).
5. Évaluer la qualité de votre agent vocal
OpenAI recommande d’évaluer les agents vocaux sur 4 dimensions (F4) :
- Résultats des tâches : Vérifiez que les actions déclenchées (ex : envoi d’email, réservation) correspondent aux intentions de l’appelant. Utilisez des scénarios répétables pour comparer les performances, comme décrit par OpenAI (F4).
- Timing conversationnel : Mesurez la latence audible (cible : < 500 ms) et la gestion des interruptions. Pour GPT-Live, séparez le temps backend (ex : requête API) du temps frontend (STT/TTS) (F5).
- Reconnaissance vocale : Testez avec des accents, du bruit de fond, et des noms propres. ElevenLabs propose des modèles multilingues, mais la latence peut augmenter pour certaines langues.
- Fiabilité des sessions : Suivez les échecs de connexion, les timeouts, et les sessions incomplètes. Twilio fournit des logs détaillés pour le débogage (F9).
Méthodologie d’évaluation (F4) :
- Crawl : Tests synthétiques avec des requêtes simples (ex : « Quel est mon solde ? »).
- Walk : Scénarios multi-tours (ex : « Je veux reporter mon rendez-vous »).
- Run : Tests en conditions réelles avec des utilisateurs finaux.
6. Limites et prérequis pour les PME
- Expertise technique : L’intégration d’OpenAI, ElevenLabs et Twilio nécessite des compétences backend (Python, APIs REST). Les exemples de code OpenAI (F1, F3) sont des points de départ, mais une adaptation est nécessaire pour les cas d’usage spécifiques.
- Coûts : Prévoyez des coûts pour :
- OpenAI : Tokens pour le raisonnement et les outils (modèle Realtime API). Consultez la documentation officielle pour les tarifs actuels.
- ElevenLabs : Synthèse vocale (facturée à la requête ou par caractère). Les coûts dépendent des tiers d’abonnement. Exemple : le format MP3 192 kbps nécessite le tier Creator (source).
- Twilio : Appels sortants (à la minute) et numéros de téléphone (tarifs).
- Conformité : Les appels automatisés sont soumis à des réglementations (ex : RGPD en Europe, TCPA aux États-Unis). Consultez un juriste pour valider votre cas d’usage. Les réglementations varient selon les pays.
- Qualité audio : La latence et la reconnaissance vocale dépendent de l’implémentation. Testez avec des utilisateurs réels avant un déploiement à grande échelle.
Lien utile : Guide d’implémentation de l’IA en entreprise pour anticiper les défis techniques et organisationnels.
Exemple de workflow pour une relance de paiement
Voici une stack technique validée pour automatiser une relance :
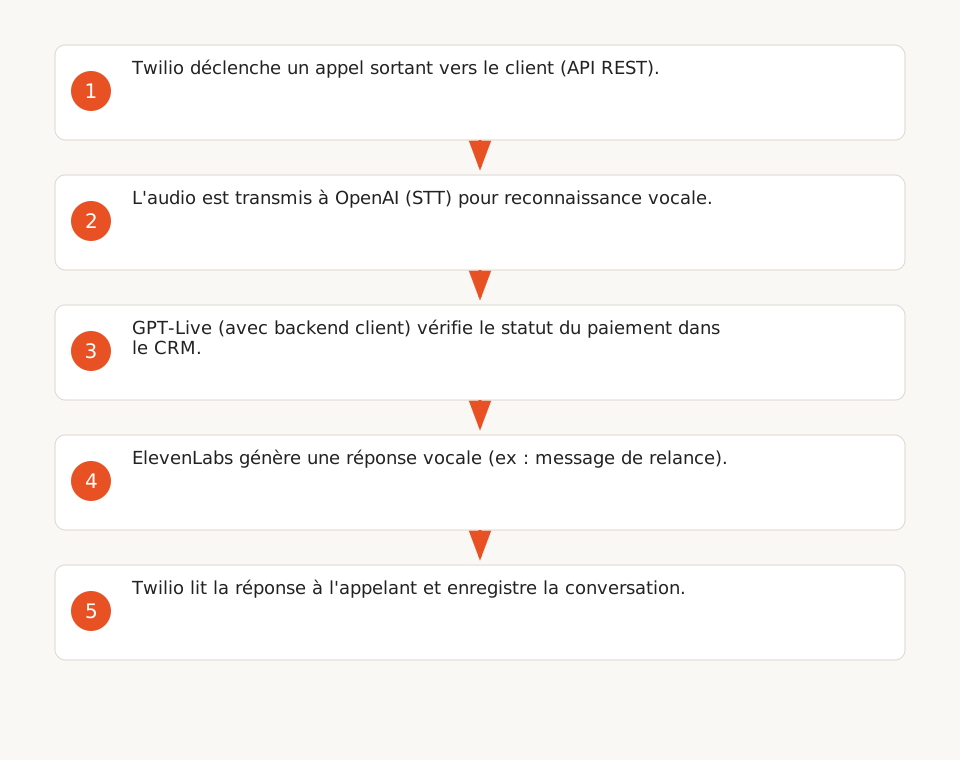
- Twilio déclenche un appel sortant vers le client (API REST).
- L’audio est transmis à OpenAI (STT) pour reconnaissance.
- GPT-Live (avec backend client) vérifie le statut du paiement dans le CRM.
- ElevenLabs génère une réponse vocale (ex : « Votre paiement de 150 € est en retard. Souhaitez-vous le régler maintenant ? »).
- Twilio lit la réponse à l’appelant et enregistre la conversation (paramètre
Record=true).
Ce workflow peut être adapté pour d’autres cas d’usage (prise de rendez-vous, enquêtes de satisfaction).